Nomenclatura HGVS: Claves para la interpretación de secuenciaciones génicas
La interpretación de los informes de secuenciación genética puede parecer un desafío inicial, pero una comprensión clara de la nomenclatura HGVS (Human Genome Variation Society) puede facilitar enormemente la tarea. Esta nomenclatura estándar permite una precisión en la descripción de mutaciones genéticas, proporcionando una base común para la comunicación y la interpretación de resultados. La nomenclatura HGVS es crucial porque permite que los profesionales de la salud puedan entender y comparar hallazgos entre diferentes estudios, lo que es fundamental en el diagnóstico y tratamiento de enfermedades genéticas.
Nomenclatura HGVS: Conceptos Fundamentales
Antes de entender la nomenclatura, es esencial conocer el marco de referencia utilizado en secuenciaciones genéticas. Este marco de referencia define el punto inicial desde donde se cuentan las posiciones de nucleótidos en el genoma. Varias variables pueden influir en este marco de referencia, incluyendo la estructura del gen, el tipo de secuencia analizada (genómica, codificante, etc.), y las particularidades del ensayo genético utilizado.
Nomenclatura HGVS: Clave para la Descripción de Mutaciones
La nomenclatura HGVS permite describir cualquier tipo de mutación en forma de una sola línea. Primero, se identifica la secuencia afectada (ADN codificante, genómico, mitocondrial, etc.), seguido por la posición y el tipo de mutación. Las principales reglas utilizadas para nombrar una variante genética son:
- c. para ADN codificante: Ejemplo: c.76A>T, indicando una sustitución de adenina por timina en la posición 76.
- g. para secuencia genómica: Ejemplo: g.476A>T.
- m. para secuencia mitocondrial: Ejemplo: m.8993T>C.
- n. para ARN no codificante: Ejemplo: n.76A>T.
- p. para secuencia de proteína: Ejemplo: p.Arg1543>Lys, indicando una mutación que cambia una arginina en la posición 1543 por una lisina.
Además, se utilizan signos y símbolos para describir tipos específicos de mutaciones:
- Substituciones: c.76A>T indica una sustitución de adenina por timina.
- Duplicaciones: c.76dupA indica una duplicación en la posición 76.
- Delecciones: c.76_78delACT indica una delección de tres nucleótidos desde la posición 76 hasta la 78.
- Inserciones: c.76_77insG indica una inserción de guanina.
- Inversas: c.76_83inv indica una inversión de nueve nucleótidos desde la posición 76 hasta la 83.
En caso de múltiples cambios en el mismo individuo, se deben nombrar individualmente. Por ejemplo, c.[76A>C];[87delG] indica dos cambios en diferentes alelos.
Uso Práctico en Neuropediatría
La nomenclatura HGVS es crucial en neuropediatría para interpretar resultados de secuenciación genética. Por ejemplo, una mutación en el gen BRCA1 (c.76A>T) puede indicar un alto riesgo de desarrollo de cáncer de mama o ovario, mientras que una mutación en el gen SLC26A2 (c.76dupA) puede estar asociada a la enfermedad de Pendred, un defecto del tejido conductil auditivo.
Transcríto: Identificación del Trascrito
La posición de una mutación se refiere al inicio de un trascrito, que es una versión del gen que se transcribe en ARN mensajero (mRNA). Debido a la existencia de múltiples trascritos de un mismo gen, es crucial identificar el trascrito correcto para una interpretación precisa. La base de datos RefSeq es una herramienta valiosa para esto, indexando todas las moléculas biológicas humanas de origen natural, codificadas con un número único.
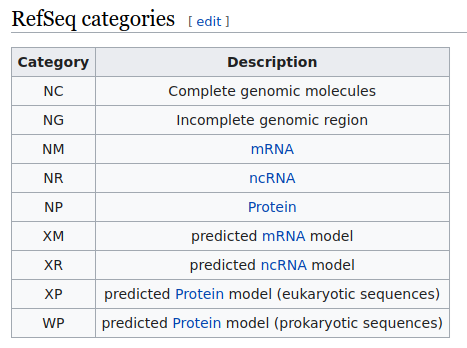
En un informe de secuenciación, la posición del cambio de bases suele aparecer precedida por NM, indicando el trascrito en el que se basa la posición. Otros términos como NG y NC pueden aparecer según el tipo específico de molécula analizada.
Genoma de Referencia: Evolución y Importancia
El marco de referencia genómico utilizado en la secuenciación es crucial para la interpretación precisa. El консорциум эталонного генома es responsable de mantener y actualizar el genoma de referencia, GRCh38. Este genoma incluye variantes existentes en diversas poblaciones humanas para representar la diversidad genética global. La inclusión de estos datos mejora la precisión de los análisis genéticos, especialmente en la detección de mutaciones raras o geográficamente específicas.
La información sobre el genoma de referencia suele aparecer en los apéndices del informe de secuenciación, proporcionando contexto sobre la versión utilizada y cualquier modificación en la base de datos.
🔗 Consultar recurso enlazado: Cómo entender un informe de secuenciación.